1. SageMaker Training Jobs
SageMaker Training Jobs run your training code on managed infrastructure. You specify the algorithm, data location, compute resources, and hyperparameters. SageMaker provides instances, runs training, saves the model to S3, and terminates instances.
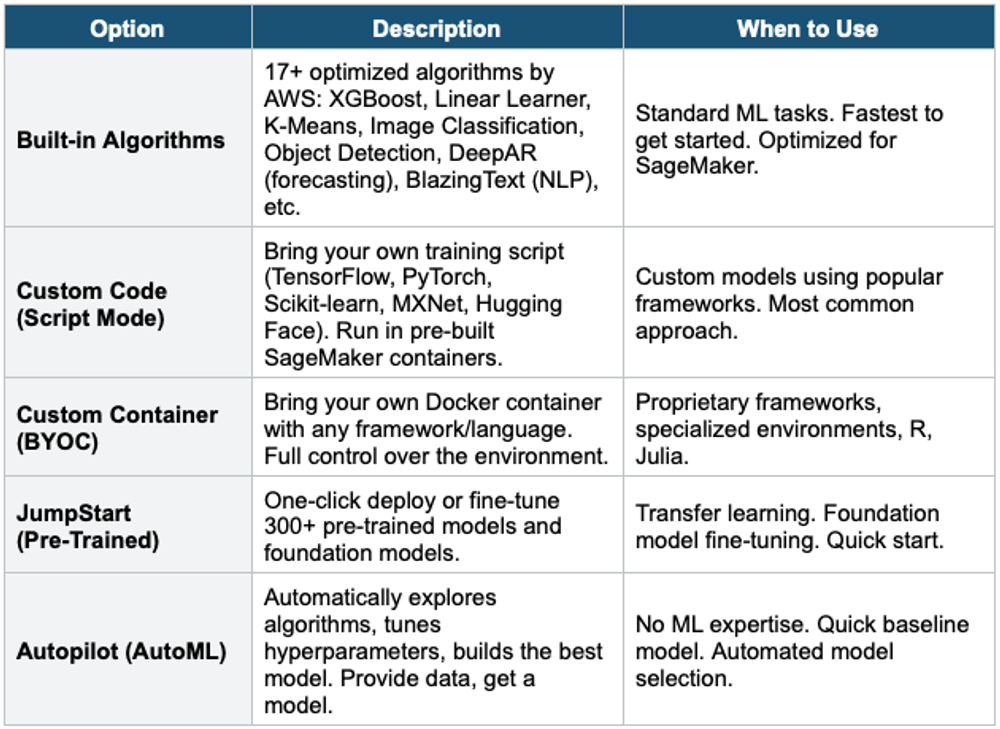
Core Concept SageMaker training = managed GPU/CPU instances that spin up, train your model, and shut down. You pay only while training runs. No idle costs. Supports: built-in algorithms, custom code (any framework), or pre-trained models from JumpStart.
Training Options
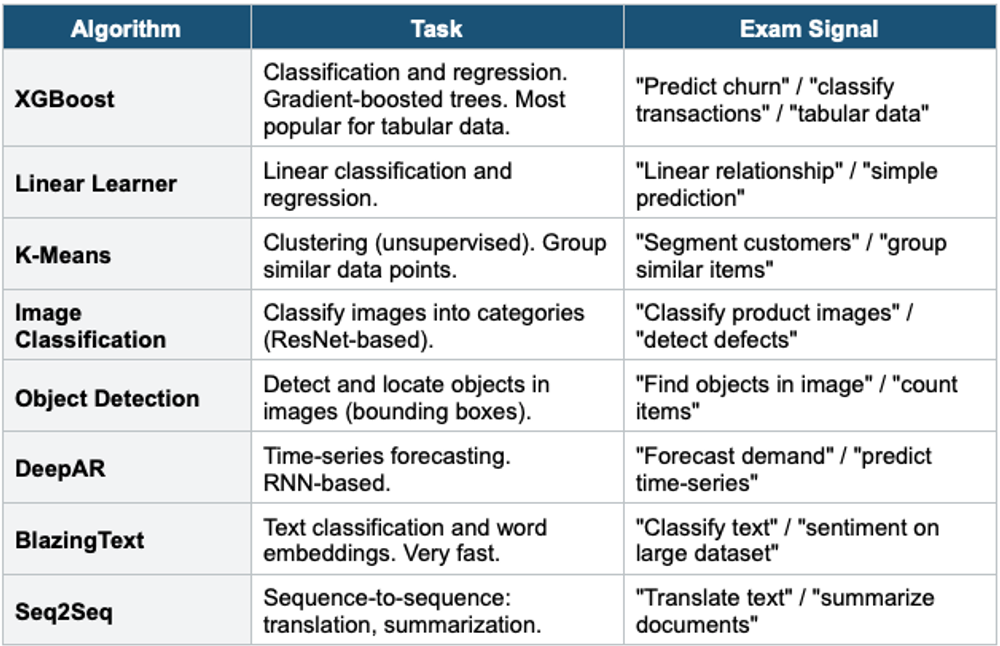
Key Built-in Algorithms
2. Training Data Input
- Training data is typically stored in S3
- Input modes: File mode (download to instance), Pipe mode (stream from S3, faster for large datasets), FastFile mode (POSIX access to S3)
- Data formats: CSV, RecordIO-Protobuf (optimized for built-in algorithms), Parquet, JSON, image files
- Data channels: train, validation, test (separate S3 paths)
3. Distributed Training
- Data Parallelism: split data across multiple GPUs/instances. Each processes a subset. Combine gradients.
- Model Parallelism: split the MODEL across multiple GPUs (for models too large for one GPU).
- SageMaker handles distribution automatically when you configure an instance count > 1
- Use for: large datasets (data parallelism) or large models like LLMs (model parallelism)
4. Hyperparameter Tuning (HPO)
SageMaker Automatic Model Tuning finds the best hyperparameters by running multiple training jobs with different configurations.
- Define: hyperparameter ranges (learning rate: 0.001–0.1, epochs: 10–50, etc.)
- Objective metric: what to optimize (maximize accuracy, minimize loss)
- Strategy: Bayesian (intelligent search, most efficient), Random (simple), Grid (exhaustive), Hyperband (early stopping)
- Runs multiple training jobs in parallel
- Returns the best-performing hyperparameter combination
- Use for: optimizing model performance without manual trial-and-error
5. Managed Spot Training
- Use EC2 Spot Instances for training to save up to 90% on compute costs
- SageMaker handles interruptions: saves checkpoints to S3, resumes from checkpoint
- Best for: training jobs that are fault-tolerant and can resume from checkpoints
- Not recommended for: time-critical training with strict deadlines
Exam Tip Training: "Built-in algorithms" = 17+ optimized (XGBoost most popular). "Custom TensorFlow/PyTorch" = Script Mode. "No ML expertise" = Autopilot. "Find best hyperparameters" = Automatic Model Tuning (Bayesian). "Save training cost" = Managed Spot Training (90% savings). "Large dataset" = Pipe mode input. "Large model" = Model Parallelism. "Tabular prediction" = XGBoost. "Time-series" = DeepAR.